Cómo diseño y opero la capa de enrutamiento, streaming y observabilidad detrás de toda la plataforma de operaciones de Amor Eterno — sin depender de una nube pública.
El problema
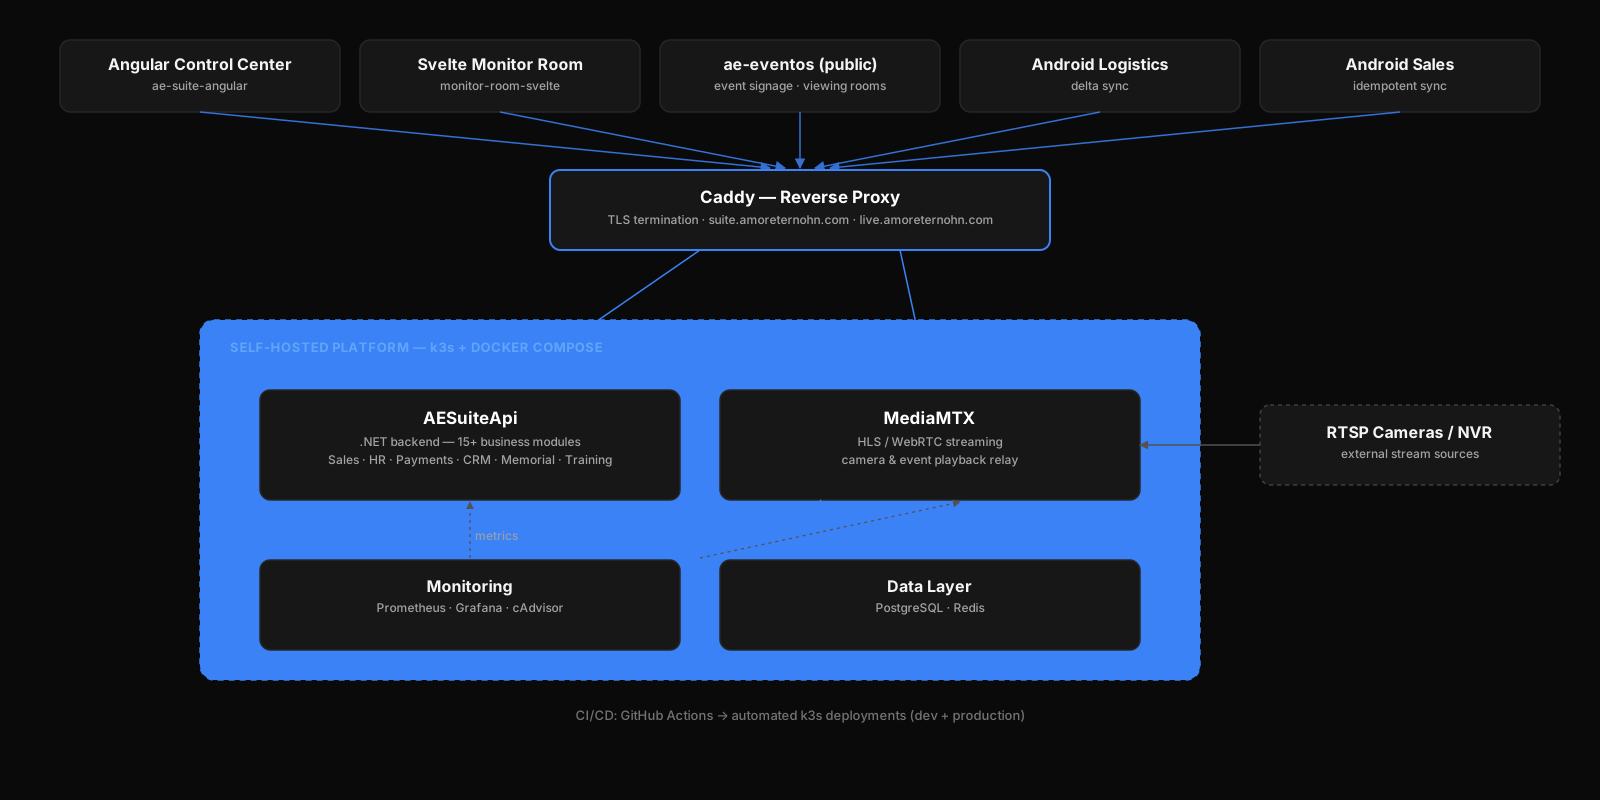
Para 2025, las operaciones de Amor Eterno habían crecido hasta convertirse en una familia de aplicaciones separadas — un centro de control en Angular, una sala de monitoreo en Svelte, un sitio público de señalización de eventos y dos apps Android — todas necesitando llegar de forma segura a un mismo backend compartido, sobre TLS, sin que cada app reinventara el enrutamiento, los certificados o el despliegue. El streaming de cámaras y eventos en vivo agregó un requisito completamente distinto: reproducción HLS/WebRTC de baja latencia que un simple proxy reverso no podía resolver por sí solo.
La arquitectura
Caddy está en el borde, terminando TLS y enrutando cada dominio público (suite.amoreternohn.com, live.amoreternohn.com, entre otros) al servicio de backend correcto. Detrás, manifiestos y overlays de k3s ejecutan los despliegues de la API en producción y desarrollo, mientras un stack de Docker Compose ejecuta MediaMTX para la ingesta de cámaras/NVR y reproducción HLS/WebRTC, junto con PostgreSQL y Redis para los servicios que los necesitan.
Observabilidad y operación
Un stack de Prometheus, Grafana y cAdvisor monitorea la salud de los contenedores y el uso de recursos en toda la plataforma, respaldado por backups programados del estado de k3s y verificaciones de salud de canales RTSP. Los despliegues están automatizados de extremo a extremo: workflows de GitHub Actions envían builds de desarrollo y producción directo a k3s, con pipelines separados para el código de la API y las migraciones de base de datos con EF Core, para que un release nunca dependa de un paso manual en un servidor que tengo que recordar.
Por qué importa
Cada aplicación de la familia AE Suite — interna y pública — depende de que este edge funcione correctamente. Diseñarlo y operarlo en solitario significó que cada cambio de enrutamiento, renovación de certificado y pipeline de despliegue tuviera un solo responsable de punta a punta, desde el Caddyfile hasta el overlay de k3s y el dashboard de Grafana que me dice si en verdad está funcionando.